 German
 English
 French
 Dutch

Der Begriff ‘kontinuierliches maschinelles Lernen’ gewinnt zunehmend an Bedeutung. Diese leistungsstarke Technologie treibt unsere digitale Welt in die Zukunft voran und hat erheblichen Einfluss darauf, wie Unternehmen mit ihrem wichtigsten Kapital umgehen: Informationen.
In dieser ausführlichen Betrachtung werden wir den Zusammenhang zwischen maschinellem Lernen mit kontinuierlichem Training und der Archivierung wichtiger Dokumente untersuchen – und dabei sowohl die Chancen als auch die potenziellen Fallstricke dieses komplexen Prozesses aufzeigen.
Was versteht man unter „Continuous Training“ im Bereich des maschinellen Lernens?
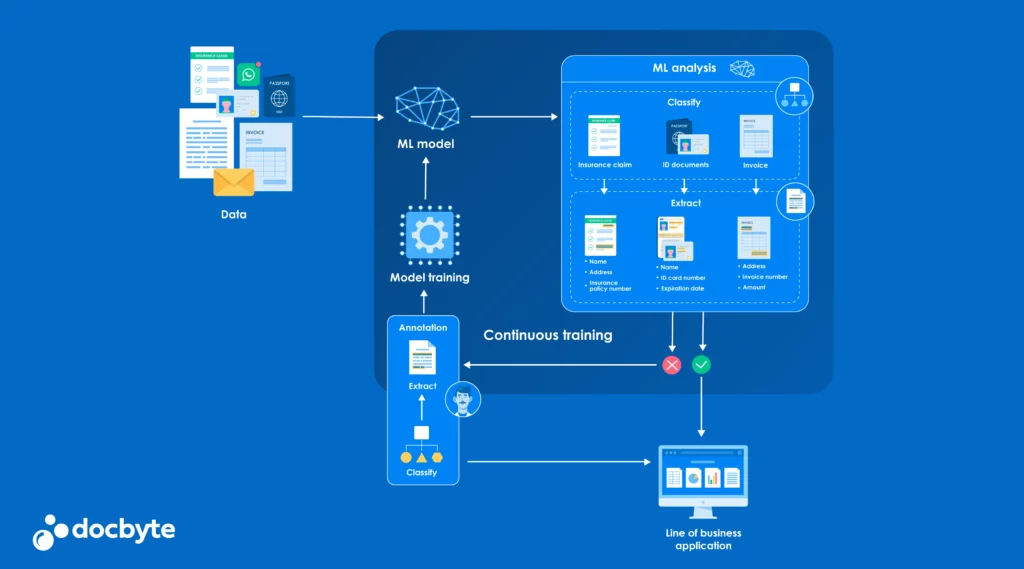
Bevor wir uns damit befassen, wie sich das kontinuierliche Training im Bereich des maschinellen Lernens (ML) mit der Dokumentenarchivierung verknüpft, müssen wir zunächst dessen Kernprinzipien verstehen. Das kontinuierliche Training im Bereich des maschinellen Lernens, das oft als fortlaufender oder inkrementeller Lernprozess beschrieben wird, ermöglicht es Modellen des maschinellen Lernens, sich selbst zu aktualisieren und zu erweitern, sobald kontinuierlich neue Daten zur Verfügung stehen.
Dieses dynamische Paradigma eignet sich besonders für Szenarien, in denen große Datenmengen vorliegen und diese raschen sowie unvorhersehbaren Veränderungen unterliegen. Durch das erneute Trainieren der Modelle anhand der aktuellsten Daten erhalten Unternehmen eine genauere und aktuellere Darstellung der Umgebung, die das ML-Modell ‘verstehen’ soll.
Doch warum ist dies im Zusammenhang mit der Dokumentenarchivierung von entscheidender Bedeutung? Die Antwort liegt in der Fähigkeit von ML-Modellen, Muster zu erkennen und wertvolle Erkenntnisse aus allen ihnen zur Verfügung gestellten Dokumenten und Daten zu gewinnen – und unsere Dokumente sind unser wertvollstes Kapital.
ML in der Praxis: Klassifizierung von Dokumenten
Die Dokumentenklassifizierung – also die Einteilung von Dokumenten in Kategorien anhand ihres Inhalts – ist ein zentraler Anwendungsfall für maschinelles Lernen. Durch kontinuierliches Training im Bereich des maschinellen Lernens lässt sich der Prozess der Dokumentenklassifizierung mit jedem neuen Datensatz verfeinern. Wenn Dokumente in einem System archiviert werden, tragen sie zum fortlaufenden Training des Systems bei, wodurch der Klassifizierungsprozess im Laufe der Zeit immer genauer wird.
Nehmen wir beispielsweise eine Anwaltskanzlei, die Schriftsätze, Rechtsprechung und Mandantenkorrespondenz kategorisieren muss. Durch den Einsatz von ML-Verfahren mit kontinuierlichem Lernen kann das System aus den spezifischen Merkmalen jeder Dokumentart ‘lernen’ und so seine Genauigkeit und Effizienz kontinuierlich verbessern.
ML in der Praxis: Informationsextraktion
Über die Klassifizierung von Dokumenten hinaus eignet sich maschinelles Lernen (ML) auch hervorragend für die Informationsextraktion, also den Prozess des Abrufens bestimmter Datenpunkte aus einem Dokument. Ein Finanzinstitut muss Kundeninformationen aus verschiedenen Formularen und Verträgen extrahieren.
Durch kontinuierliches Training sind ML-Modelle in der Lage, Kundennamen, Adressen und andere relevante Angaben zu identifizieren und zu extrahieren, wobei sie sich an neue Dokumentformate anpassen, sobald diese eingeführt werden.
Diese Funktion spart nicht nur Zeit, sondern gewährleistet auch eine höhere Genauigkeit bei der Datenextraktion, da das ML-Modell im Laufe der Zeit immer weiter verfeinert wird.

Herausforderungen des maschinellen Lernens bei der Dokumentenarchivierung
Trotz des großen Potenzials von ML in der Dokumentenarchivierung ist diese Technologie nicht frei von Herausforderungen. Ein solches Hindernis ist die Gewährleistung der Sicherheit und des Datenschutzes der archivierten Daten. Wenn Menschenleben von der Richtigkeit der verarbeiteten Informationen in Dokumenten abhängen können – wie beispielsweise im medizinischen Bereich – oder wenn personenbezogene Daten weitergegeben werden, wie etwa bei Finanzunterlagen, ist das Risiko einer Verletzung der Privatsphäre hoch.
Darüber hinaus besteht die Sorge vor einer ‘übermäßigen Abhängigkeit’ von maschinellem Lernen. Diese Systeme können zwar ihre Aufgaben äußerst kompetent ausführen, sind jedoch flexibel. Fehler treten auf, wenn Dokumente von den erwarteten Mustern abweichen oder Modelle Daten falsch interpretieren. Daher ist es unerlässlich, Änderungen an Dokumentmodellen oder Datenstrukturen an Ihre Qualitätskontrollabteilung oder die für das ML-System zuständige Stelle weiterzuleiten. Auf diese Weise können die Genauigkeit der Dokumentklassifizierung und der Datenextraktion überprüft werden.
Häufige Fehler in Dokumenten
Um beim Thema potenzieller Fehler zu bleiben, wollen wir uns nun einige der häufigsten Fehler beim Scannen und Archivieren von Kundenausweisen ansehen. Angesichts der zunehmenden Verbreitung der digitalen Identitätsprüfung ist die Gewährleistung der Genauigkeit von Ausweisscans von entscheidender Bedeutung. Fehler wie unvollständige Scans, eine schlechte Bildauflösung oder eine Fehlausrichtung beim Scannen können zu fehlerhaften oder unbrauchbaren Daten führen.
Wenn diese Fehler zur Archivierung oder Analyse in ein ML-System eingespeist werden, können sie Ungenauigkeiten weiterverbreiten und so einen Dominoeffekt von Problemen im gesamten Archivierungsprozess auslösen. Daher müssen Unternehmen in ihren Scan- und Archivierungsabläufen Maßnahmen zur Qualitätssicherung ergreifen.

Maschinelles Lernen mit menschlichem Eingriff
An der Schnittstelle zwischen maschinellem Lernen und Archivierung ist menschliches Eingreifen oft nach wie vor unverzichtbar. Dieses „Human-in-the-Loop“-Konzept stellt sicher, dass ML-Modelle ihre Lernkurven auf dem richtigen Kurs halten. Fachexperten können eine entscheidende Rolle bei der Validierung von ML-Ergebnissen, der Korrektur von Fehlern und der Bereitstellung von Feedback spielen, das das Modell dazu anleitet, genauere Vorhersagen und Entscheidungen zu treffen.
Ein weiterer zu berücksichtigender Aspekt ist das regulatorische Umfeld. Compliance-Beauftragte und Rechtsabteilungen fungieren als „Gatekeeper“, die sicherstellen müssen, dass die Prozesse zur Archivierung und zum Abruf von Dokumenten den neuesten Vorschriften entsprechen.

Vorteile des maschinellen Lernens bei der Dokumentenarchivierung
Zwar gibt es Herausforderungen bei der Implementierung dieser Systeme, doch sind die Vorteile beträchtlich. Die maschinell lernbasierte Dokumentenarchivierung optimiert die Abläufe und reduziert körperliche Arbeit, und steigert die Effizienz. Es ermöglicht Unternehmen, das Potenzial ihrer Datenbestände auf bisher undenkbare Weise zu nutzen und liefert Erkenntnisse und Trends, die in unstrukturierten Daten verborgen lagen.
Darüber hinaus sorgt die Dynamik des kontinuierlichen maschinellen Lernens dafür, dass Unternehmen flexibel genug bleiben, um neue Dokumenttypen und Datenformate zu integrieren, sobald diese aufkommen. Dadurch wird die Dokumentenarchivierung von einer statischen Anforderung zu einem strategischen Vorteil, der Business Intelligence und Innovation vorantreibt.
Die Zukunft gestalten
Das kontinuierliche Training im Bereich des maschinellen Lernens eröffnet beispiellose Möglichkeiten in der Dokumentenarchivierung und darüber hinaus. Es verspricht, die Art und Weise zu verändern, wie wir die Vergangenheit verwalten und die Zukunft gestalten – und zwar mithilfe der Erkenntnisse, die wir aus unseren umfangreichen Dokumentensammlungen gewinnen. Doch mit großer Macht geht auch große Verantwortung einher. Unternehmen, die sich in diesem Bereich bewegen, müssen umsichtig vorgehen und die Vorteile des maschinellen Lernens nutzen, ohne dabei die damit verbundenen Risiken aus den Augen zu verlieren.
Sowohl für IT-Fachleute als auch für Juristen wird ein proaktiver und fundierter Ansatz der Schlüssel sein, um das volle Potenzial des maschinellen Lernens mit kontinuierlicher Weiterbildung im Bereich der Dokumentenarchivierung auszuschöpfen. Auf diese Weise werden Unternehmen ihre internen Prozesse optimieren. Zudem werden sie den Weg für eine neue Ära der digitalisierten, intelligenten Archivierung ebnen, die sich an die jeweiligen Unternehmen anpassen und mit ihnen wachsen kann.
Verwandte Seiten zu Docbyte-Lösungen
Fahren Sie mit den Docbyte-Lösungsseiten fort, die zu diesem Thema passen:


