 German
 English
 French
 Dutch


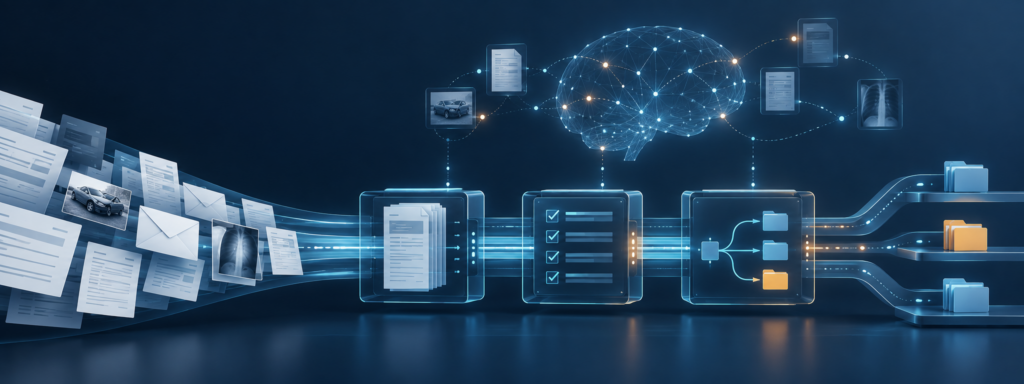
Docbyte arbeitete mit einem großen Versicherungsunternehmen zusammen, um ein großes Sprachmodell zu integrieren
(LLM) als Ebene für kontextbezogene Schlussfolgerungen auf der Grundlage eines bestehenden Dokuments
Arbeitsablauf. Der Arbeitsablauf selbst blieb unverändert.
Der Workflow zur intelligenten Dokumentenverarbeitung (IDP) des Versicherers ist bereits
bearbeitete die eingehende Korrespondenz von Kunden und Maklern, setzte dabei jedoch verstärkt
Traditionelle Technologien: Kombination aus cloudbasierten Modellen des maschinellen Lernens
mit Schlüsselwortregeln. Nichts Besonderes, aber es hat funktioniert. Außerdem war noch Folgendes erforderlich:
ständige Anpassungen, da sich Dokumentformate, Produkte und Terminologie
Die ständigen Änderungen und Dokumenttypen mit hoher Ähnlichkeit waren schwer voneinander zu unterscheiden.
zuverlässig voneinander zu unterscheiden. Den Modellen des maschinellen Lernens fehlte die erforderliche Fähigkeit,
durch Nuancen und Zusammenhänge zu argumentieren, was starre Regeln schlichtweg nicht vermögen
Erfassung.
Das Problem:
ein Arbeitsablauf, der ständig Ihre Aufmerksamkeit erforderte
Der Workflow verarbeitet an einem Arbeitstag etwa 50.000 Dokumente. Etwa
97% des eingehenden Materials besteht aus E-Mails von Kunden, Versicherern und
Makler, oft mit mehreren Anhängen, die größtenteils digital erstellt wurden,
mit einigen eingescannten Seiten und handschriftlichen Einträgen dazwischen. Für jede einzelne davon
Dokumente: Für diesen Vorgang sind zwei Angaben erforderlich: Um welche bestehende Forderung es sich handelt,
zu wem sie gehört und um welche Art von Anfrage es sich handelt.
Es handelt sich also eindeutig um eine Aufgabe im Bereich der Informationsklassifizierung: Das Identifizieren von
die richtige Dokumentenart, die richtige Fallart und den richtigen Anspruch. Die Klassifizierung ist schwieriger
als die Datenextraktion. Viele IDP-Plattformen bieten lediglich die Extraktion an,
denn sie denken: “Hey, wir müssen doch nur die Schadensnummer extrahieren, und
einige Stichwörter!”
Der falsche Typ, aber die richtige Groß-/Kleinschreibung, lässt sich schnell korrigieren. Keine Groß-/Kleinschreibung
Eine Übereinstimmung führt überhaupt dazu, dass das Dokument zur Überprüfung durch einen Mitarbeiter weitergeleitet wird, da es keine
ein sicheres automatisches Fallback dafür. Die Typklassifizierung ist wichtig, aber sie
ist die sekundäre Kennzahl.
Der Versicherer hat diesen Ansatz in seinem Geschäftsbereich Kfz-Versicherung erprobt:
das umsatzstärkste Geschäftsfeld des Unternehmens und zugleich das mit der komplexesten,
Dokumentensatz, der am schwersten zu unterscheiden ist. Dieser wurde bewusst als
anspruchsvoller Testfall. Sollte die Schlussfolgerungsebene die Messlatte bei
Das größte Problem, mit dem das Unternehmen zu kämpfen hatte, war, dass es sich nicht lohnte, dies weiter auszubauen.
weiter.
Das Pilotprojekt umfasste 16 vom Unternehmen definierte Dokumentklassen: Angebot
Anfragen, Angebote und Verträge, Änderungen der Versicherungsbedingungen, Registrierung
sowie Stornierungsanträge, Kündigungsmitteilungen, Informationsanfragen,
Sterbeanzeigen, Insolvenzmeldungen. Diese sind optisch nicht immer
unterschiedliche Vorlagen. Eine Abmeldebescheinigung, wenn ein Kennzeichen
Eine Aufhebung kann auch die Kündigung der entsprechenden Versicherung zur Folge haben. Dies
bezieht sich auf ein bestimmtes Geschäftsereignis und nicht auf eine Standardstornierung
Sprache. Genau das ist die Art von Mehrdeutigkeit, die das Schlüsselwort und
Maschinelle Lernmodelle, die auf Beispielen trainiert wurden, haben Mühe, hier mitzuhalten.
Die Ausgangsbasis: ein System
das rutschte ab
Bevor das Team etwas Neues testete, ermittelte es zunächst, wo die tatsächlichen
stand. Das bestehende Modell nutzt OCR als Eingabe und wurde etwa um 60% herum in Betrieb genommen
bei dieser Aufgabe präzise und hatte sich auf etwa 40% als Formate und
Die Terminologie hatte sich gewandelt. Eine Umschulung kam ebenfalls nicht in Frage. Das Dokument
Die Typen waren nie einheitlich neu beschriftet worden, sodass es keine verlässliche
eine verlässliche Quelle, anhand derer man trainieren kann.
Dieser Rückgang war von größerer Bedeutung als die bloße Zahl. Ein Modell, das
Die im Laufe der Zeit zunehmende Genauigkeit führt dazu, dass mehr Arbeit in die manuelle Überprüfung verlagert wird, und diese Verlagerung
verschlimmert sich, je länger das Modell unverändert läuft.
Was
wurde entwickelt: ein LLM, das auf die bestehende Plattform aufgesetzt wurde
Im Rahmen des Projekts wurde der kontrollierte Dokumenten-Workflow beibehalten und um folgende Elemente erweitert:
ein LLM als Schlussfolgerungsebene darüber. Die Pipeline:
- Erfassen Sie die E-Mail und ihre Anhänge, einschließlich gescannter
Material. - Wandeln Sie die Eingabe in eine PDF-Darstellung um.
- Senden Sie es an das LLM mit den zulässigen Klassifizierungen, geschäftlich
Definitionen und Entscheidungsregeln. - Geben Sie die Fallnummer, eine strukturierte Klassifizierung und das Modell zurück.
automatisch generierte Erklärung. - Überprüfen Sie das Ergebnis und exportieren Sie es in das Fallmanagement
Umfeld, in dem die eigentliche nachgelagerte Aktivität stattfindet.
Dem Modell wird keine Aufgabe mit offenem Ausgang gestellt. Um das Risiko zu verringern und
Betriebliche Auswirkungen nicht unterstützter Antworten: Jede Anfrage löst einen neuen Prozess aus,
eingeschränkte Sitzung, und die Klassifizierung muss aus einer abgeschlossenen Menge stammen
der zulässigen Werte. Deterministische Dienste steuern weiterhin die Validierung,
Weiterleitung, Speicherung und Ausführung von Arbeitsabläufen. Diese Abgrenzung ist es, die
Ist es möglich, den Ergebnissen des Modells zu vertrauen, ohne dem
das Modell selbst.
Da die Anspruchszuweisung die entscheidende Kennzahl ist, behandelt die Pipeline
Es verhält sich folgendermaßen: Die extrahierte Fallnummer durchläuft einen deterministischen
Validierte und ungültige Ergebnisse werden an eine Person weitergeleitet, anstatt erzwungen zu werden
zu einer plausibel erscheinenden Übereinstimmung. Die Behandlung von Typfehlklassifizierungen erfolgt eher
nachsichtig, da dies der Fehler ist, dessen Behebung weniger Kosten verursacht. Das vom Modell generierte
Die Erklärung wird ebenfalls in der Benutzeroberfläche angezeigt. Dies ist zudem kein Beweis dafür, dass
Die Antwort ist zwar richtig, ermöglicht es den für den Fall zuständigen Mitarbeitern jedoch, Folgendes einzusehen:
warum es dort gelandet ist, anstatt das Dokument hin und her zu schicken. Das ist
mehr oder weniger so, wie es auch bei menschlichen Sachbearbeitern der Fall sein sollte,
wobei eine Person ein Dokument anders klassifizieren würde als
seinen/ihren Kollegen. Darüber hinaus hilft dies den Implementierungsteams dabei,
systematische Fehler zu beseitigen und Dokumentdefinitionen zu verfeinern.
Aus diesen Fehlern haben wir gelernt
etwas Nützliches
Die auffälligste Verwechslung betraf die Unterscheidung zwischen einer Abmeldung und
eine allgemeine Stornierung. Anstatt einen Umschulungszyklus durchzuführen, handelt es sich hierbei um
Behoben durch eine Präzisierung der Klassifizierungsdefinition: Abmeldung als
spezifischer Untertyp der Löschung, der ausdrücklich mit dem Kennzeichen verknüpft ist
Entfernung. Um ein bekanntes Fehlermuster zu beheben, muss eine Definition bearbeitet werden
anstatt ein Modell zu trainieren oder umzutrainieren.
In einem separaten Test wurde geprüft, ob das LLM einen Mehrwert für die Dokumente erbrachte
die am wichtigsten waren: jene, die das bestehende ML-Modell bereits erkannt hatte
falsch. Das LLM hat 7% der Dokumente in dieser Teilmenge korrekt klassifiziert,
die gerade deshalb ausgewählt wurden, weil das bestehende Modell sie falsch klassifiziert hatte.
Dies ist kein direkter Gesamtvergleich, da das bestehende Modell
Die Genauigkeit für dieselbe Teilmenge beträgt konstruktionsbedingt 0%, zeigt jedoch die
Die „Reasoning“-Ebene hat einen nennenswerten Teil des bestehenden Arbeitsablaufs
Fehlschläge. Das bedeutet, dass sich die Erfolgsquote von 0% auf 73% für
diese Ausnahmen.
Die bisherigen Ergebnisse
Die nachstehenden Zahlen geben Aufschluss über die Klassifizierung nach Dokumenttyp, wobei der sekundäre
metrisch. Die Zuordnung der Groß- und Kleinschreibung selbst wird nicht auf dieselbe Weise bewertet: Die extrahierten
Entweder besteht die Fallnummer die deterministische Validierung oder nicht, und
Alles, was unklar ist, wird einer manuellen Überprüfung unterzogen, anstatt als
Prozentsatz.
| Vorgehensweise | Genauigkeit |
|---|---|
| Vorhandenes ML-Modell (abgeleitet von einem Anfangs ~60%) |
40% |
| LLM (Gemini 2.5 Flash) – vollständiger Test Beispiel |
80% |
Der Wert von 80% wurde ohne zusätzliches Modelltraining oder
Feineinstellung anhand eines ersten Testdatensatzes, der manuell überprüft und mit
die Fachexperten des Versicherers. Der Vorteil ergab sich aus dem Modell, das
die Fähigkeit, die Beziehungen zwischen den einzelnen Phrasen innerhalb einer E-Mail zu bewerten und
sowie deren Anhänge und eine in natürlicher Sprache verfasste Geschäftsdefinition anzuwenden
eine Sprache, anstatt eine, die in ein proprietäres, neu trainierbares System integriert ist
Klassifikator.
Was dies für die
Wirtschaft
Im Tagesgeschäft verläuft der Arbeitsablauf nun in drei konkreten Punkten anders
Wege.
- Mehrsprachige Verarbeitung: Die Lösung erzielt dieselben Ergebnisse in
jede Sprache, ohne dass für jede Sprache ein Dokumentensatz erforderlich ist, um
das Modell trainieren. - Die Verfeinerung von Regeln wird einfacher: Eine bekannte Unklarheit, wie beispielsweise die
Überlappung bei der Abmeldung/Stornierung wird durch Schärfen eines
Definition, nicht durch das Neu-Trainieren eines Modells oder das Abwarten einer neuen Version
Zyklus. - Die Überprüfung wird transparenter: die vom Modell generierte Erklärung
wird in der Benutzeroberfläche angezeigt, sodass die mit einem Fall betrauten Mitarbeiter erkennen können, warum dies
ist dort gelandet, anstatt es herumzureichen, um es herauszufinden.
A
Tipp: Beziehen Sie die Sicherheitsabteilung und den Datenschutzbeauftragten ein, bevor der Business Case
fertig
Ein überzeugendes Geschäftsmodell allein reicht nicht aus. Wenn das Unternehmen
möchte einen LLM in den Arbeitsablauf integrieren, jedoch unter Berücksichtigung der Sicherheit oder des Datenschutzbeauftragten
hat noch nicht genehmigt, wohin die Daten übermittelt werden, wie sie aufbewahrt werden und wer
Wenn man darauf nicht zugreifen kann, kommt das Projekt nicht in Gang, ganz gleich, wie gut die Genauigkeit auch sein mag
Wie sehen die Zahlen aus? Beziehen Sie diese Interessengruppen mit ein, solange die Architektur noch
Dies wird noch entschieden, nicht erst, nachdem ein Pilotprojekt das Konzept bereits unter Beweis gestellt hat.
Genau dieser Befehl führt am häufigsten dazu, dass ein funktionierender Pilot ins Stocken gerät, bevor er
Produktion: Es werden ausschließlich der Datenfluss, die Aufbewahrungsfristen und die Bestimmungen zur Datenverarbeitung überprüft
sobald das Konzept bereits funktioniert, anstatt während die Architektur noch
noch offen.
Die Konzeption und die anfängliche Entwicklung dauerten etwa drei bis vier Monate.
Der Großteil dieser Zeit floss in die Neugestaltung der Pipeline selbst sowie in
Gespräche mit dem Unternehmen über Dokumenttypen und darüber, was
unterscheidet das eine vom anderen. Der LLM macht es nicht überflüssig,
dieses Fachwissen. Es erleichtert das Formulieren, Testen und Verfeinern,
Und genau das ist die Arbeit, die derzeit im Gange ist, um von 80% auf 90% umzustellen.
IDP bietet nach wie vor Erfassung, Strukturierung und Steuerung, und das LLM ergänzt dies um
darüber hinaus eine kontextbezogene Interpretation. Geschäftsregeln, Validierung und
Es sind die Menschen, die diese Kombination in einen Prozess verwandeln, der
vertrauenswürdig. Anstatt sich ausschließlich auf die Klassifikationsgenauigkeit zu konzentrieren,
Die entscheidende Kennzahl ist, wie oft das Dokument den richtigen Fall auf der
Erster Versuch.
Rückblick
Wie Ihr Dokumenten-Workflow mit den Fällen umgeht, die nicht in das Schema passen
Wir können Ihnen dabei helfen, zu ermitteln, wo eine LLM-Schlussfolgerungsebene in Ihrem Unternehmen am meisten helfen würde.
Dokumenten-Workflow: Welche Klassifizierungen sind mehrdeutig, was ist eine sichere
Wie die Ausweichlösung durch eine manuelle Überprüfung aussieht und wie die Fallvalidierung weiterhin erfolgt
deterministisch, während das Modell die Interpretation übernimmt.
Häufig gestellte Fragen
Ist
Bedeutet die Einführung eines LLM, dass das bestehende IDP-System abgeschafft wird?
Nein. Das LLM wird als Schlussfolgerungsmodul auf den bestehenden Arbeitsablauf aufgesetzt.
Ebene. Deterministische Validierung, Weiterleitung und Fallbearbeitung finden nach wie vor
die weiteren Vorgänge zu steuern.
Warum
Sollte man die Fallzuordnung anstelle der Gesamtgenauigkeit der Klassifizierung betrachten?
Denn die beiden Fehler sind mit unterschiedlichen Kosten verbunden. Ein Dokument auf der rechten Seite
Ein Fall, bei dem der Typ falsch ist, lässt sich schnell neu zuordnen. Ein Dokument, das mit keinem
Der Fall wird zur manuellen Überprüfung weitergeleitet, ohne dass ein automatischer Ausweichprozess zum Einsatz kommt.
Warum
Warum nicht mit dem schwierigsten Dokumentensatz beginnen, anstatt mit dem einfachsten?
Um herauszufinden, ob sich dieser Ansatz unter realen Bedingungen bewährt
frühzeitig, anstatt zunächst einen weniger bedeutenden Punkt in einem einfacheren Geschäftsbereich zu belegen
und die schwierigere Frage offen zu lassen.
